Jev ve AWS Strands Decider 2B Karşılaştırması: Hangi Karar Modeli Seçilmeli?
Yapay zeka ajanlarında yeni standart haline gelen karar modellerinin iki önemli temsilcisi TypeSafe AI Jev ve AWS Strands Decider 2B'yi; zeka skoru, yerel çalışma, kalibrasyon ve maliyet ekseninde kıyaslıyoruz.
Otonom yapay zeka ajanlarının (AI Agents) kurumsal yazılımların merkezine yerleşmesiyle birlikte, yapay zeka dünyasında yepyeni bir model kategorisi doğdu: Karar Modelleri (Decision Models). Geleneksel büyük dil modellerinin (LLM) her küçük yönlendirme ve araç seçimi için binlerce token harcamasına alternatif olarak geliştirilen bu modeller, metin üretmek yerine doğrudan yapılandırılmış kararlar döndürüyor.
Bu yeni kategorinin öncülüğünü System One ve Jev ile TypeSafe AI yaparken, çok geçmeden Amazon Web Services (AWS) cephesinden AWS Strands Decider 2B hamlesi ve Perplexity gibi oyuncuların karar odaklı modelleri geldi. Peki bir yazılım mimarı veya mühendislik lideri olarak ajan altyapınızı kurarken TypeSafe AI Jev modelini mi yoksa AWS Strands Decider 2B gibi açık ağırlıklı alternatifleri mi tercih etmelisiniz?
1. Dağıtım Modeli: Yönetilen Bulut API vs. Açık Kaynak (Self-Hosted)
İki model arasındaki en temel ayrım, yazılıma nasıl eriştiğiniz ve onu nerede çalıştırdığınız noktasında başlıyor:
- AWS Strands Decider 2B (Açık Kaynak & Yerel): Qwen3.5-2B gövdesi üzerine inşa edilen ve Apache 2.0 lisansıyla Hugging Face üzerinden açık ağırlıklı olarak sunulan bir modeldir. Modeli indirip kendi sunucularınızda, uç cihazlarda veya tek bir tüketici sınıfı GPU üzerinde dış internete hiç çıkmadan çalıştırabilirsiniz.
- TypeSafe AI Jev (Yüksek Performanslı Bulut API): Kapalı ağırlıklı, özel bir paralel örnekleme altyapısı üzerinde çalışan yönetilen bir servis olarak sunulur. Sunucu yönetimi, GPU tedariki veya model ölçeklendirme zahmeti yoktur; doğrudan tip güvenli API üzerinden çağrılır.
Eğer savunma sanayii, kapalı devre bankacılık ağı veya internet bağlantısı olmayan uç (edge) cihazlar için geliştirme yapıyorsanız Strands Decider 2B doğal bir avantaj sunar. Ancak ölçeklenebilir bulut uygulamalarında operasyonel yük almamak için Jev çok daha pratiktir.
2. Zeka, Doğruluk ve Karmaşık Karar Kapasitesi
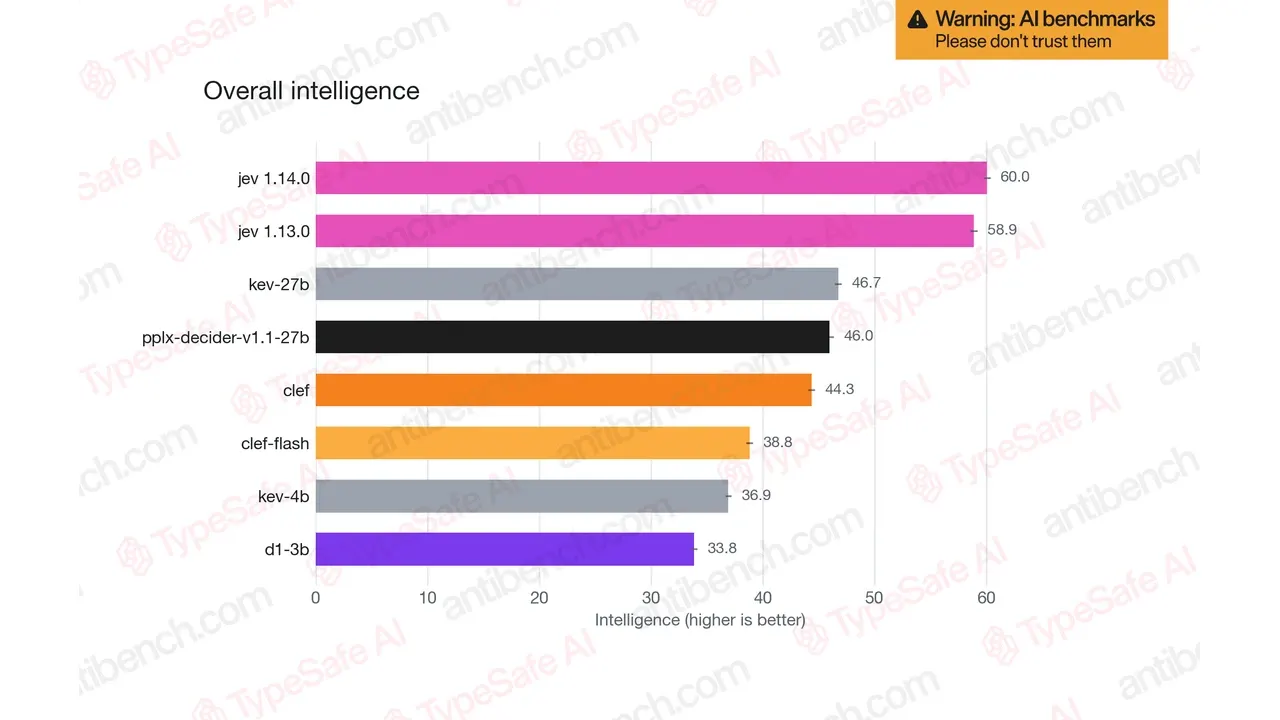
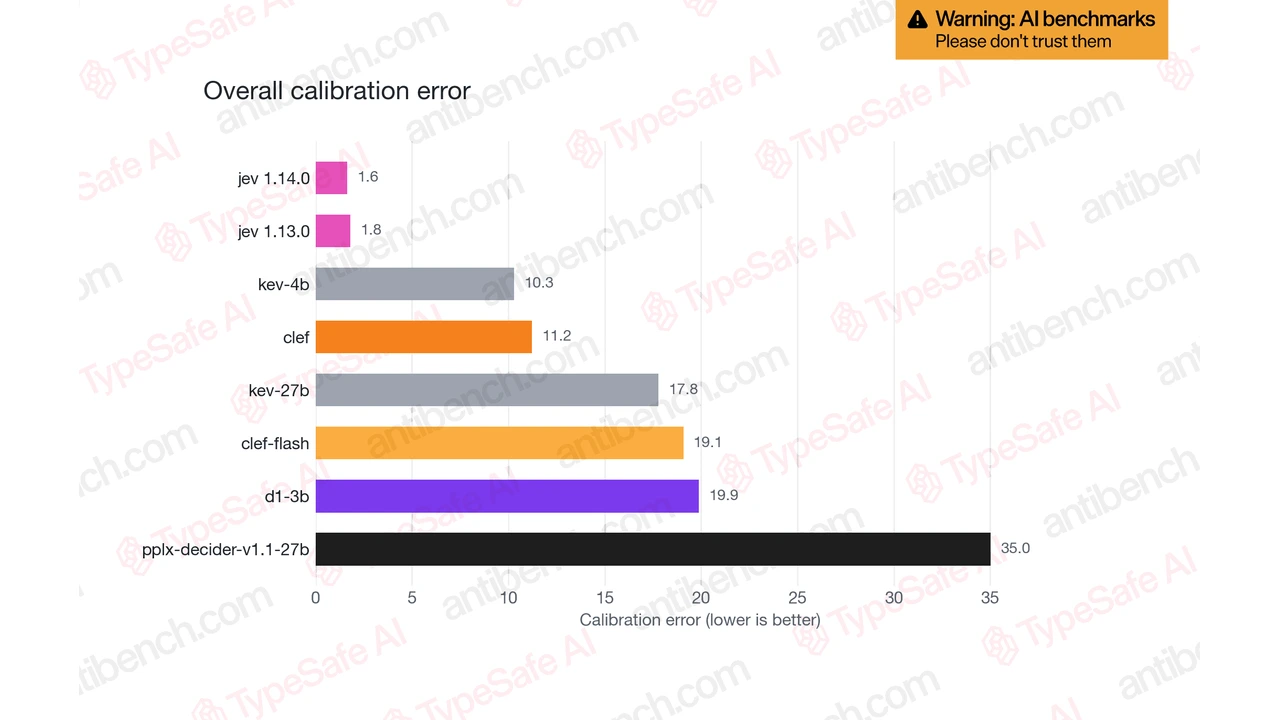
Karar modellerinin gerçek dünya iş akışlarındaki genel zeka (overall intelligence) ve kalibrasyon kıyaslamalarına baktığımızda, parametre ölçeği ve RLCD eğitim mimarisinin yarattığı fark net biçimde görülüyor.
2 milyar veya 3-4 milyar parametreli hafif karar modelleri (örneğin Strands Decider 2B veya d1-3b / kev-4b sınıfı modeller), basit ikili yönlendirmelerde ve net sınırları olan araç seçimlerinde oldukça başarılıdır. Ancak girdi bağlamı karmaşıklaştığında, birden fazla çelişkili kayıt aynı anda değerlendirildiğinde veya çok modlu (görsel + metin) kararlar gerektiğinde hafif modellerin kapasitesi hızla doygunluğa ulaşır:
- Güncel karar kıyaslamalarında 3B-4B sınıfındaki hafif modeller 33.8 ila 36.9 zeka skoru bandında kalırken ve 27B ölçeğindeki karar modelleri (
pplx-decider-v1.1-27b,kev-27b) 46.0 - 46.7 puan üretirken; - TypeSafe AI Jev 1.14.0 modeli 60.0 genel zeka skoruyla rakiplerine belirgin bir üstünlük kuruyor.
Özellikle TypeSafe AI System One mimarisi yazımızda incelediğimiz üzere, Jev tek bir sorguda 10'dan fazla karmaşık alt koşulu paralel olarak değerlendirebilirken, Pointer-Head tabanlı 2B modeller genellikle tekil bir seçenek listesi (A, B, C, D) içinden tek bir indeks seçmekle sınırlıdır.
Jev vs Geleneksel LLM’ler: Karar Modellerinde Gecikme ve Maliyet Karşılaştırması
TypeSafe AI System One Mimarisi Nedir? Jev Karar Motorunun Teknik Çalışma Prensibi
3. Kalibrasyon Doğruluğu ve Çok Modlu (Multimodal) Yetenekler
Bir karar modelini üretim ortamında güvenli kılan en önemli metrik, ürettiği güven skorunun (confidence) ne kadar doğru kalibre edildiğidir:
- Strands Decider 2B: LoRA ile karar veri setleri üzerinde ince ayar yapılmış bir Pointer-Head kullanır. Hızlı bir olasılık skoru döndürür ancak kurum içi özel verilerinizde tam kalibrasyon için genellikle kendi veri setinizle ek eğitim (fine-tuning) yapmanız önerilir.
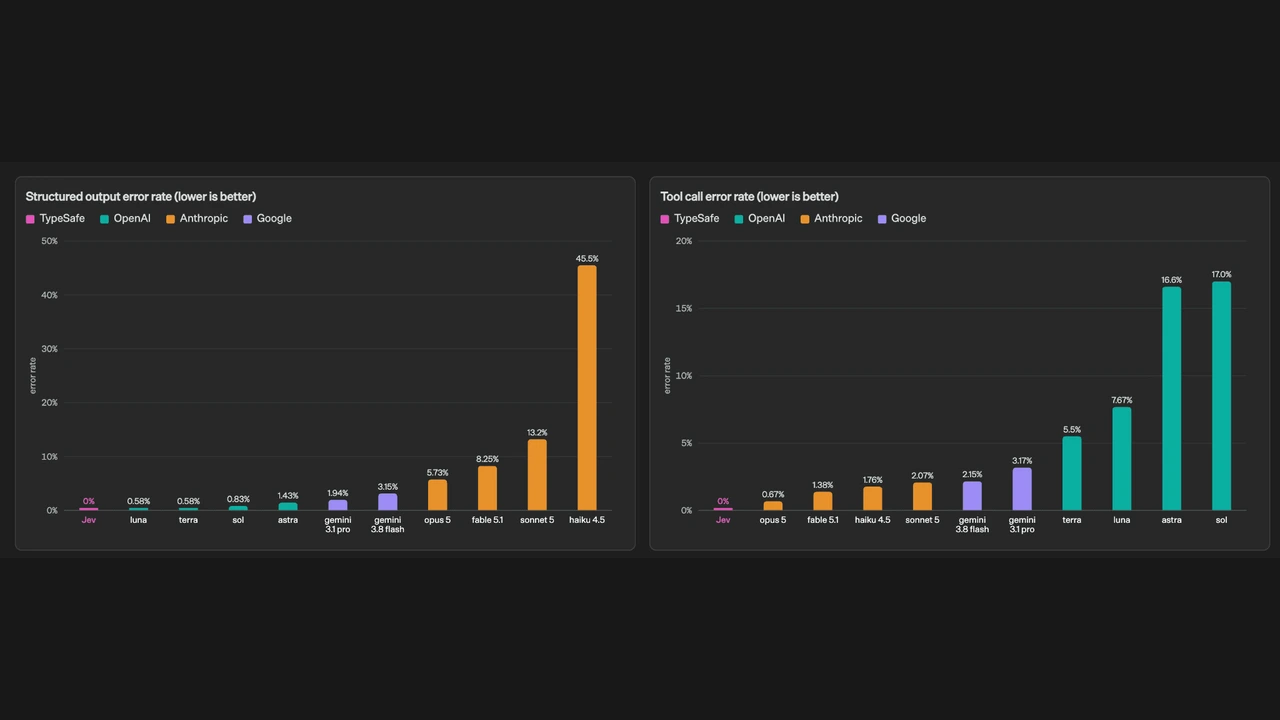
- Jev 1.14.0: Sıfır kurulumla (out-of-the-box) %1.6 gibi rekor düzeyde düşük bir kalibrasyon hatası sunar. Ayrıca 1.14 sürümüyle birlikte gelen görsel girdi desteği sayesinde, yalnızca metinleri değil ekran görüntülerini ve fotoğrafları da doğrudan yapılandırılmış kararlara (
Choice,Score,Box) dönüştürebilir. Strands Decider 2B ise yalnızca metin tabanlı durumlar üzerinde çalışır.
4. Gecikme Süresi ve Toplam Sahip Olma Maliyeti (TCO)
Her iki yaklaşım da Jev vs geleneksel LLM'ler yazımızda ele aldığımız saniyeler süren klasik LLM gecikmelerini milisaniyeler seviyesine indirir:
- Gecikme (Latency): Strands Decider 2B yerel bir RTX 4090 veya A10G GPU üzerinde çalıştırıldığında ağ gecikmesi olmadığı için 50-100 ms altında yanıt verebilir. Jev ise bulut API üzerinden 70-500 ms aralığında uçtan uca sonuç döndürür.
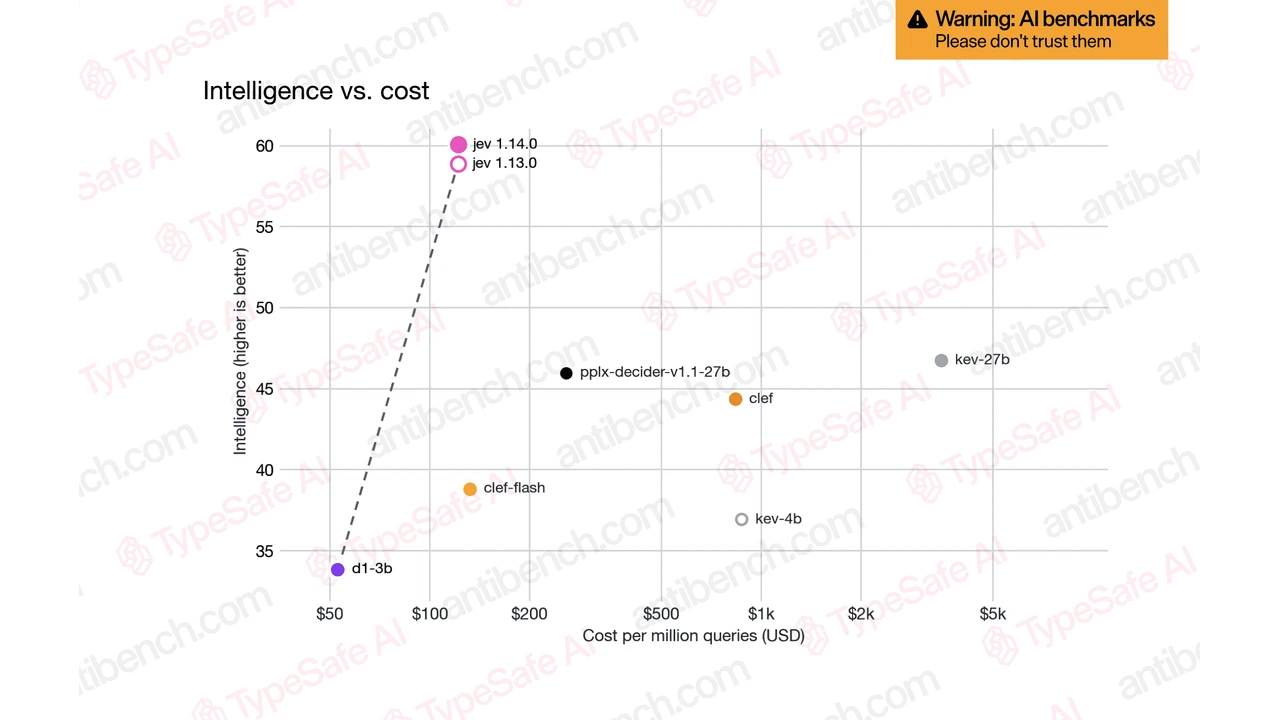
- Maliyet: Jev'de çıktı tokenları ücretsizdir ve milyon sorgu başına maliyet ~100 dolar bandındadır; yalnızca kullandığınız kadar ödersiniz. Strands Decider 2B'de ise yazılım lisansı ücretsizdir ancak modeli 7/24 ayakta tutacak GPU sunucusunun sabit kira maliyetini üstlenmeniz gerekir.
Karar Tablosu: Hangi Projede Hangisi Seçilmeli?
Özetlemek gerekirse; kendi GPU altyapınızı yönetiyor, verinin sunucu dışına çıkmasının yasak olduğu kapalı bir ortamda çalışıyor ve görevleriniz basit metin içi araç seçimlerinden oluşuyorsa AWS Strands Decider 2B harika bir açık kaynak çözümüdür.
Buna karşın; sunucu ve model eğitimiyle vakit kaybetmeden en yüksek karar doğruluğuna ulaşmak, görsel + metinsel karmaşık iş akışlarını yönetmek, %1.6 kalibrasyon hatasıyla yapay zeka ajanlarında halüsinasyonu önlemek ve kullandıkça öde modeliyle ölçeklenmek istiyorsanız TypeSafe AI Jev tartışmasız en güçlü seçenektir.