Jev vs Geleneksel LLM’ler: Karar Modellerinde Gecikme ve Maliyet Karşılaştırması
Üretim ortamındaki yapay zeka iş akışlarında geleneksel büyük dil modelleri yerine TypeSafe AI'ın Jev karar modelini kullanmanın milisaniyelik gecikme avantajlarını ve sıfır çıktı token maliyetini detaylı inceliyoruz.
Kurumsal yazılım mimarilerinde yapay zeka entegrasyonları ilk prototip aşamasından çıkıp saniyede binlerce isteğin işlendiği gerçek üretim (production) ortamlarına taşındığında, mühendislik ekiplerinin karşısına iki büyük duvar çıkar: gecikme süresi (latency) ve API faturaları. Bir kullanıcı talebini doğru kuyruğa yönlendirmek, bir içeriği denetlemek veya bir sonraki fonksiyon çağrısını seçmek için her seferinde yüz milyarlarca parametreli bir büyük dil modelini (LLM) tetiklemek, mimari açıdan ciddi bir kaynak israfı yaratır.
TypeSafe AI tarafından geliştirilen Jev, tam olarak bu darboğazı ortadan kaldırmak üzere tasarlanmış bir "System One" karar modelidir. Peki Jev nedir sorusunun ötesine geçtiğimizde, sayısal veriler ve üretim metrikleri açısından Jev ile geleneksel LLM'ler arasında nasıl bir fark bulunuyor?
Otoregresif Metin Üretimi vs. Paralel Karar Örneklemesi
Geleneksel büyük dil modelleri (GPT serisi, Claude Opus/Sonnet veya Gemini Pro gibi), doğaları gereği otoregresif (autoregressive) çalışır. Yani modelden yalnızca "evet" veya "hayır" şeklinde iki kelimelik bir sınıflandırma isteseniz bile, model çoğu zaman doğru sonuca ulaşmak için önce içsel bir düşünce zinciri (Chain-of-Thought) yürütür veya JSON şemasını kelime kelime (token-by-token) sırayla oluşturur.
Her bir yeni token üretimi, modelin devasa ağırlık matrislerinin bellekten tekrar okunması anlamına gelir:
- Geleneksel LLM Yaklaşımı: Karmaşık bir yönlendirme veya değerlendirme iş akışında uçtan uca yanıt süresi genellikle 3 saniye ile 30 saniye arasında değişir. Akıl yürütme (reasoning) modelleri devreye girdiğinde bu süre dakikaları bulabilir.
- TypeSafe AI Jev Yaklaşımı: Jev, serbest metin üretmez. System One ve Jev mimarisinde kullanılan paralel örnekleyici (parallel sampler) sayesinde, tanımlanan tüm karar tiplerini (
Choice,Score,Bool) tek bir geçişte paralel olarak hesaplar. Sonuç olarak uçtan uca yanıt süresi 70 ila 500 milisaniye aralığına iner.
Bu mimari fark, Jev'i geleneksel sınır (frontier) modellere kıyasla 40 ila 200 kat daha hızlı hale getirir. Kullanıcı arayüzünde bir düğmeye basıldığında veya bir e-ticaret sepetinde anlık dolandırıcılık (fraud) kontrolü yapılırken 150 milisaniye ile 8 saniye arasındaki fark, sistemin kullanılabilirliğini doğrudan belirler.
Maliyet Karşılaştırması: Çıktı Token Vergisinin Sonu
Yapay zeka API'lerinin fiyatlandırma tablolarına bakıldığında, çıktı (output) tokenlarının girdi (input) tokenlarından 3 ila 5 kat daha pahalı olduğu görülür. Geleneksel bir LLM'i yapılandırılmış çıktı (Structured Outputs) modunda çalıştırdığınızda; alan adları, süslü parantezler ve modelin yaptığı açıklamalar için sürekli çıktı token ücreti ödersiniz.
TypeSafe AI, Jev modelinde bu fiyatlandırma denklemini tamamen değiştirdi:
TypeSafe AI System One Mimarisi Nedir? Jev Karar Motorunun Teknik Çalışma Prensibi
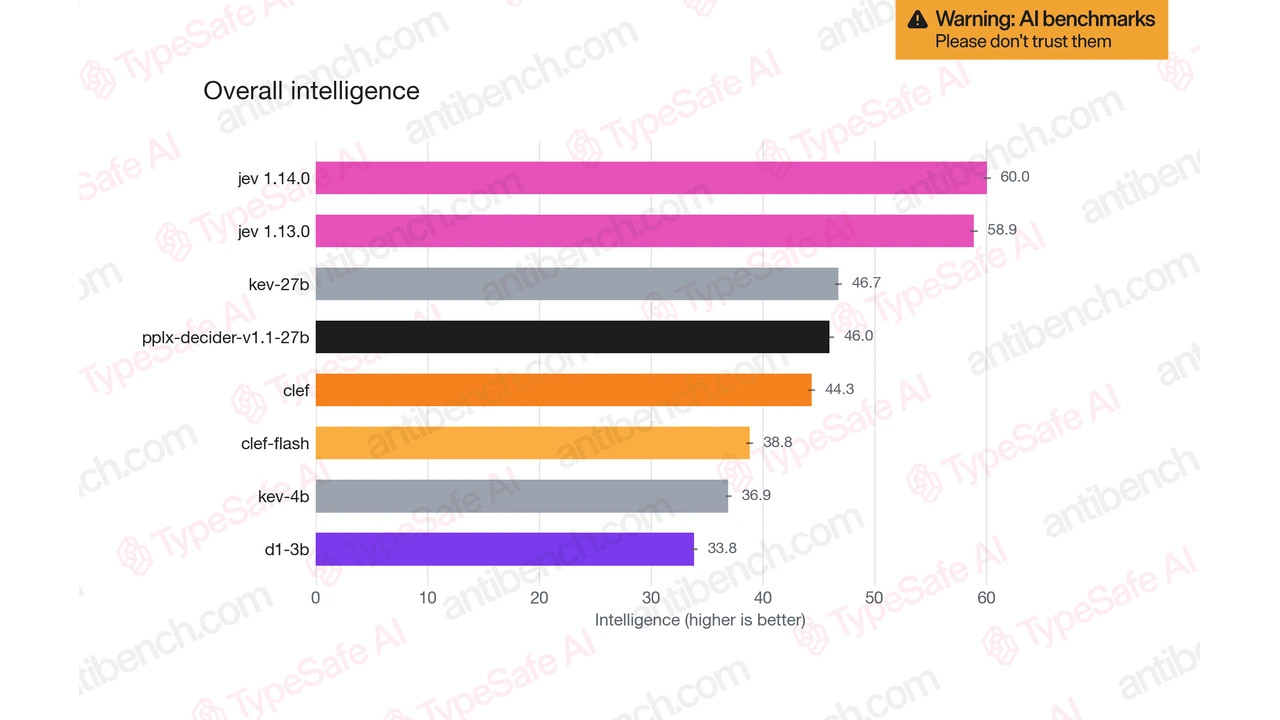
Jev ve AWS Strands Decider 2B Karşılaştırması: Hangi Karar Modeli Seçilmeli?
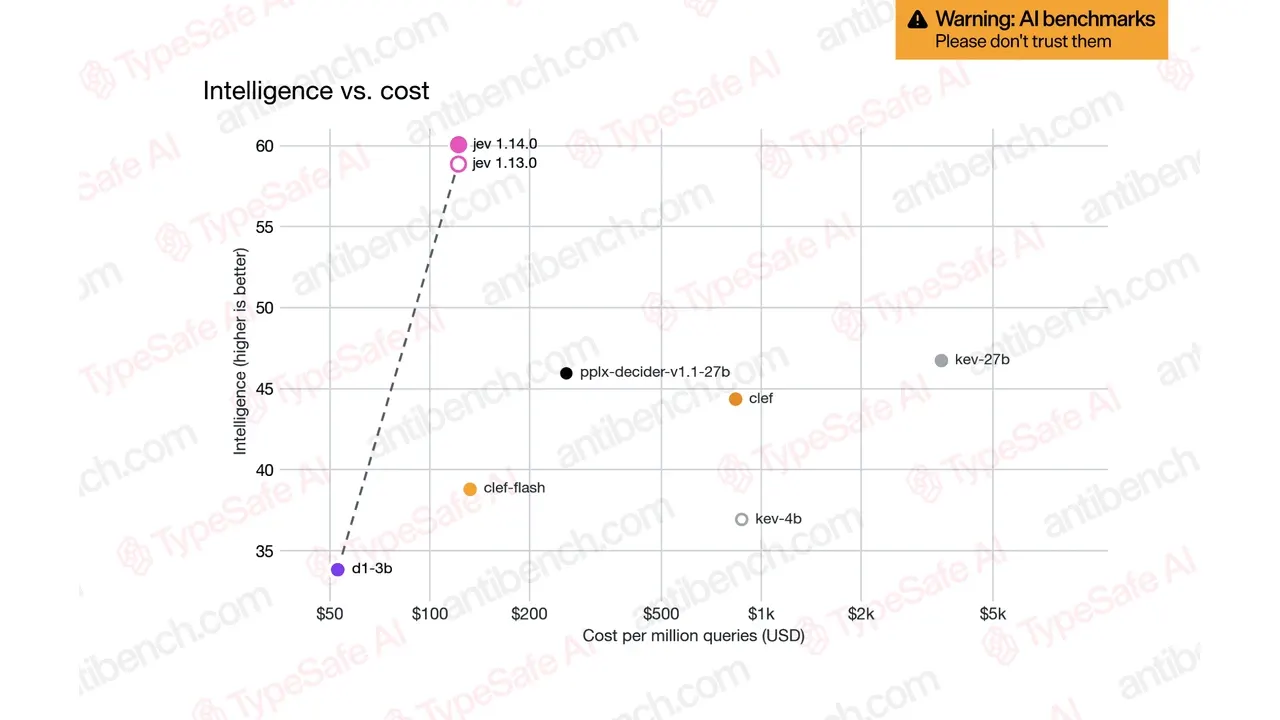
1. Sıfır Çıktı Token Maliyeti: Jev yalnızca yapılandırılmış kararlar ve olasılık dağılımları döndürdüğü için çıktı tokenları tamamen ücretsizdir. 2. Ultra Düşük Girdi Maliyeti: Girdi tarafında 1 milyon token başına yaklaşık 0.042 dolar (milyon sorgu başına ~100 dolar bandı) gibi son derece düşük bir birim maliyet uygulanır. 3. Çoklu İş Akışı Ekonomisi: Dört farklı kurumsal iş akışı üzerinde yapılan Pareto sınamalarında Jev; OpenAI, Anthropic ve açık ağırlıklı alternatiflerin çok daha yüksek maliyetle ulaştığı doğruluk oranlarını onda birinden daha düşük bir bütçeyle yakalamayı başarıyor.
Yapılandırılmış Çıktı Hataları ve JSON Kırılmaları
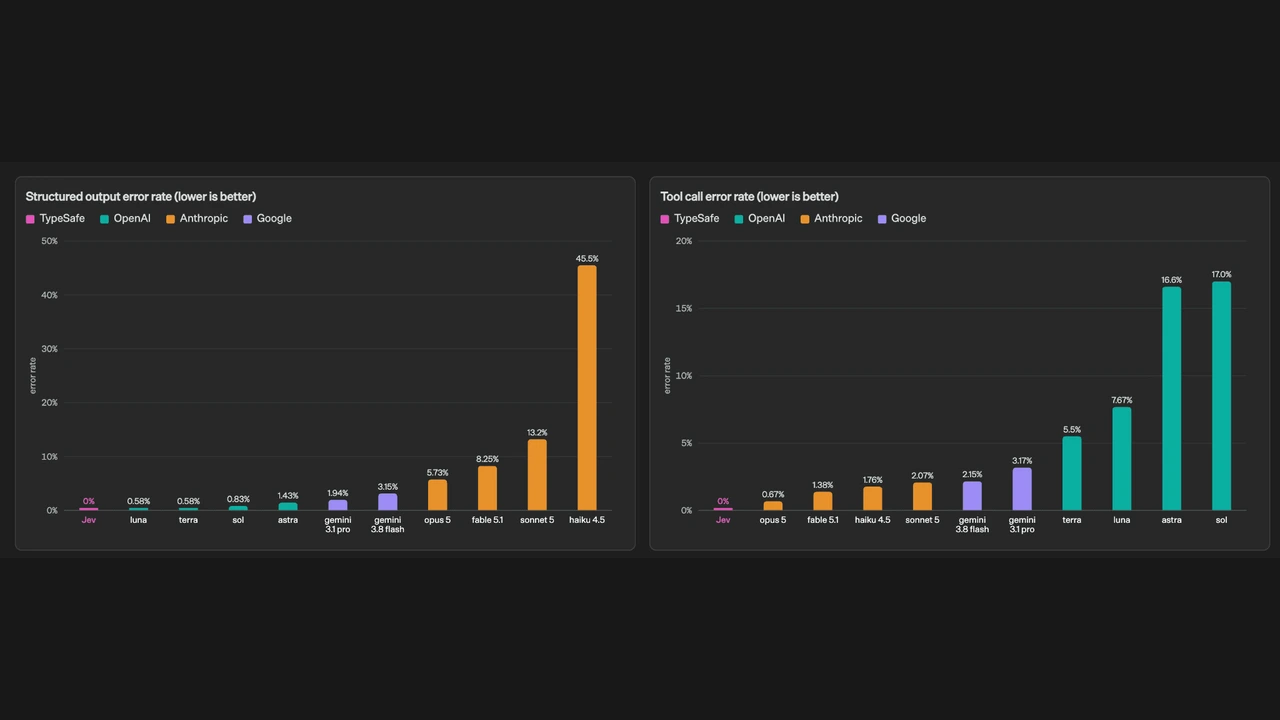
Üretim ortamında LLM kullanan yazılım geliştiricilerin en büyük kâbuslarından biri, modelin beklenmedik bir anda geçersiz JSON döndürmesi, şemada olmayan bir alanı uydurması veya yanlış veri tipi üretmesidir. Zorunlu şema doğrulama (constrained decoding) kullanılsa bile, geleneksel modellerde araç çağırma (tool calling) hata oranları %1 ile %17 arasında değişebilmektedir.
Jev ise bir metin üreticisi olmadığı ve doğrudan tip güvenli (type-safe) ilkeller üzerinde çalıştığı için yapılandırılmış çıktı hata oranı %0'dır. Tanımladığınız tipler dışında bir değerin dönmesi matematiksel olarak imkansızdır. Uygulama katmanında Jev nasıl kullanılır rehberimizde ele aldığımız gibi, dönen karar doğrudan TypeScript tiplerinizle birebir eşleşir.
Hangi Senaryoda Hangisi Seçilmeli?
Bu karşılaştırma, Jev'in tüm büyük dil modellerinin yerini alacağı anlamına gelmez. Doğru mühendislik yaklaşımı, iki teknolojiyi kendi güçlü olduğu alanlarda konumlandırmaktır:
- Ne Zaman Jev Kullanılmalı? Müşteri destek taleplerini sınıflandırma (triage), siber güvenlik uyarılarını filtreleme, otonom ajanlarda bir sonraki aracı seçme, içerik moderasyonu, risk puanlama ve gerçek zamanlı oyun/uygulama içi karar döngülerinde Jev açık ara en verimli seçenektir.
- Ne Zaman Geleneksel LLM Kullanılmalı? Karar verildikten sonra kullanıcıya empatik bir e-posta metni yazılması, sıfırdan karmaşık bir algoritma kodlanması, uzun bir PDF raporunun özetlenmesi veya yaratıcı beyin fırtınası yapılması gerektiğinde görev büyük dil modellerine devredilmelidir.
Özetle Jev, büyük dil modellerinin önünde duran ultra hızlı ve ekonomik bir "karar kapısı" olarak konumlandırıldığında, hem bulut faturalarını dramatik biçimde düşürüyor hem de kullanıcılara anlık tepki veren modern yazılımlar inşa edilmesini sağlıyor.