TypeSafe AI System One Mimarisi Nedir? Jev Karar Motorunun Teknik Çalışma Prensibi
Daniel Kahneman'ın bilişsel teorisinden ilham alan TypeSafe AI System One mimarisinin teknik detaylarını, RLCD eğitim metodolojisini ve Jev modelinin %1.6'lık rekor kalibrasyon doğruluğunu inceliyoruz.
Yapay zeka araştırmalarında son birkaç yıla damgasını vuran ana akım eğilim, modelleri daha uzun süre "düşündürmek" oldu. OpenAI, Anthropic, Google ve DeepSeek gibi devler; karmaşık matematik, fizik ve mimari kodlama problemlerini çözmek için binlerce düşünce tokenı üreten System 2 (Sistem 2) akıl yürütme modellerine milyarlarca dolar yatırım yaptı. Ancak Nobel ödüllü ekonomist ve psikolog Daniel Kahneman'ın ünlü "Hızlı ve Yavaş Düşünme" teorisinde belirttiği gibi, insan beyni kararlarının %95'ini uzun uzadıya analiz ederek değil; hızlı, sezgisel ve otomatik çalışan System 1 (Sistem 1) mekanizmasıyla alır.
Eski OpenAI hizalama (alignment) araştırmacısı Diogo Almeida liderliğindeki TypeSafe AI, yapay zeka dünyasındaki bu büyük boşluğu görerek System One ve Jev model ailesini geliştirdi. Peki System One mimarisi kaputun altında tam olarak nasıl çalışıyor ve Jev'i standart bir dil modelinden ayıran temel mühendislik prensipleri neler?
System 1 vs. System 2: "Acı Ders" ve Doğru Görev Seçimi
Yapay zeka literatüründe Rich Sutton'ın ünlü "The Bitter Lesson" (Acı Ders) makalesi, hesaplama gücü (compute) ölçeklendikçe genel yöntemlerin her zaman kazanacağını savunur. Ancak TypeSafe AI araştırmacıları, kurumsal otomasyonlarda asıl sorunun hesaplama eksikliği değil, yanlış görev tanımı (wrong task formulation) olduğunu kanıtlıyor.
Yapılandırılmış bir yazılım kararını (örneğin bir güvenlik uyarısının gerçek bir saldırı olup olmadığını puanlamayı) serbest metin üreten bir System 2 modeline verdiğinizde, model doğru cevabı bulmak için dolambaçlı bir metin üretme sürecine girer. System One mimarisi ise görevi en temelden yeniden tanımlar:
- Sözlük Tahmini Yerine Karar İlkelleri: Modelin son katmanı 100.000 kelimelik bir sözlükten (vocabulary) bir sonraki heceyi tahmin etmeye çalışmaz. Bunun yerine
Bool(İkili karar),Choice(Çoklu seçim),Score(Sürekli değer puanlama) veBox(Görsel koordinat) gibi matematiksel ilkeller üzerinde doğrudan olasılık dağılımı üretir. - Paralel Örnekleme (Parallel Sampler): Bir olay hakkında 10 farklı alt sorunun yanıtlanması gerekiyorsa, geleneksel modeller bunları arka arkaya yazarken System One mimarisi tüm soruları tek bir ileri besleme ve paralel örnekleme adımında aynı anda çözer.
Kalibrasyon Hatasında (Calibration Error) Rekor Düşüş: %1.6
Bir karar modelinin zekası kadar kritik olan diğer özelliği kalibrasyonudur. Kalibrasyon hatası (Expected Calibration Error - ECE), modelin kendine duyduğu güven ile gerçek dünyadaki isabet oranı arasındaki sapmayı ölçer.
Örneğin bir model 100 farklı işleme "%90 eminim" diyorsa, iyi kalibre edilmiş bir modelde bu işlemlerin tam 90 tanesinin doğru çıkması gerekir. Eğer sadece 60 tanesi doğru çıkıyorsa, model aşırı özgüvenlidir (overconfident) ve üretim ortamında güvenilmezdir.
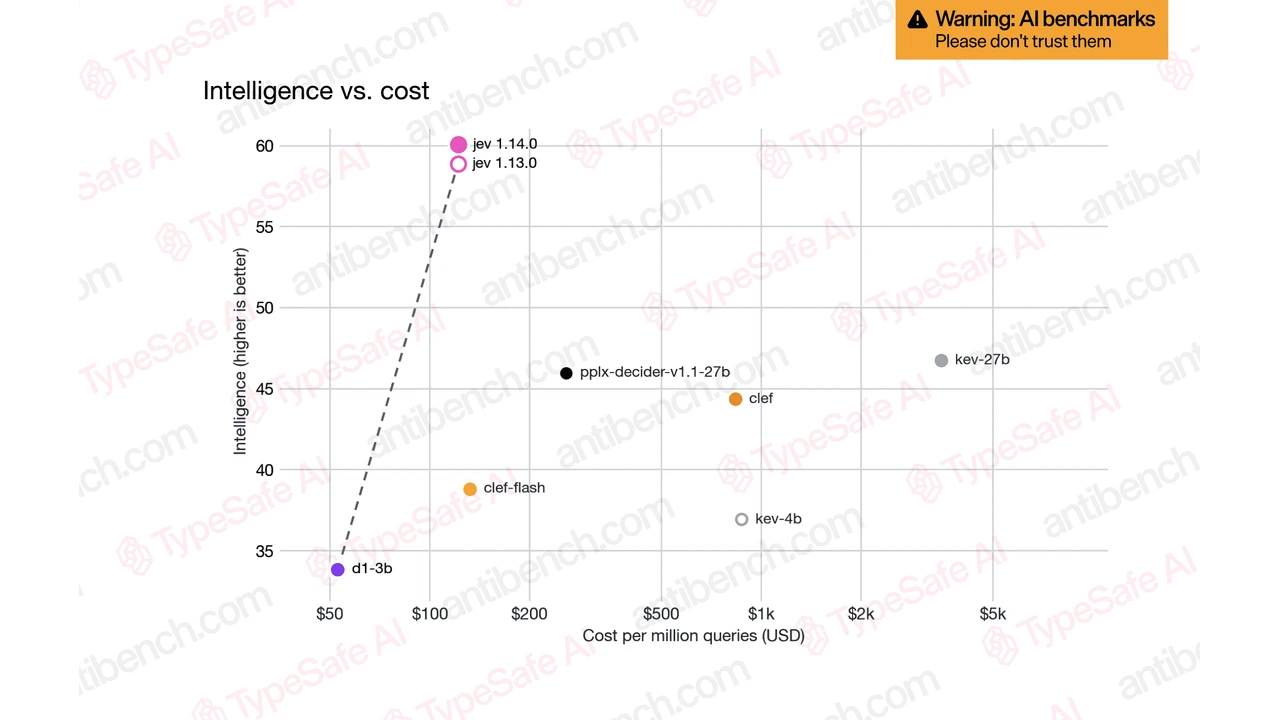
Jev vs Geleneksel LLM’ler: Karar Modellerinde Gecikme ve Maliyet Karşılaştırması

Mistral Large 4 Tanıtıldı: 1 Trilyon Parametreli Dev MoE Modeli 'Le Chonk'
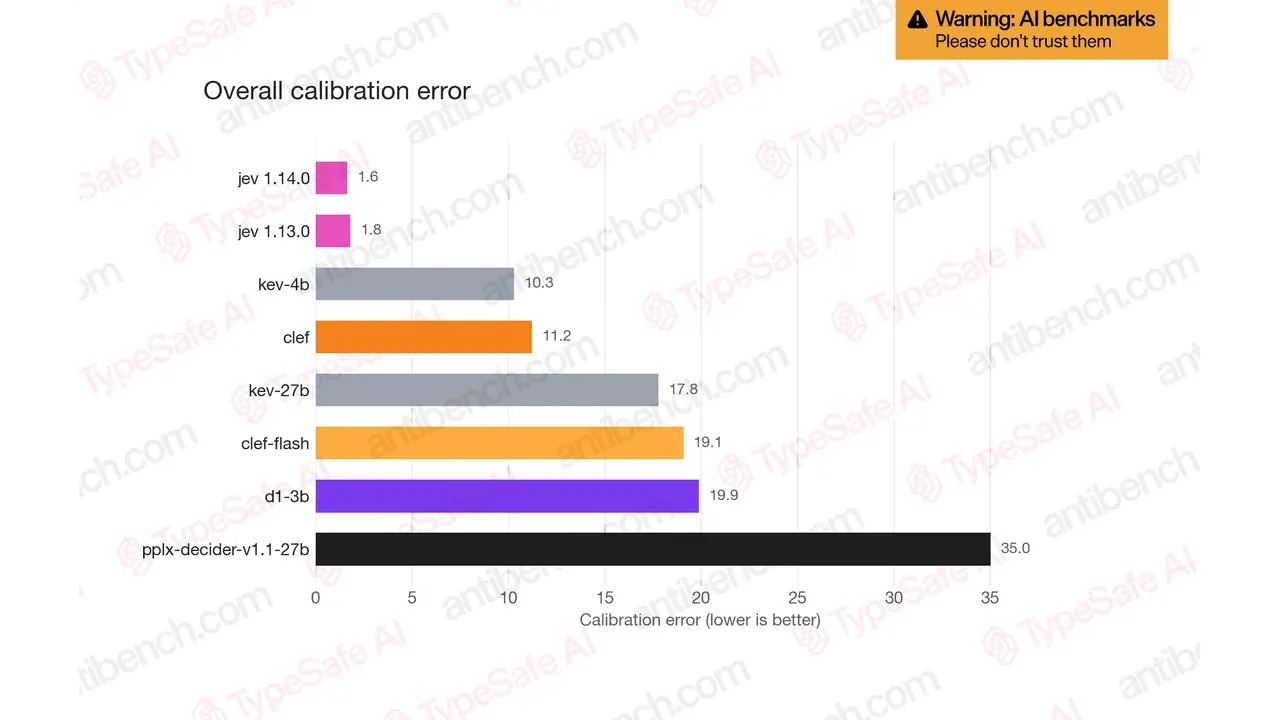
TypeSafe AI'ın güncel kıyaslama testlerinde (Jev 1.13.0 ve Jev 1.14.0 sürümleri) ortaya çıkan kalibrasyon hatası tablosu, System One mimarisinin başarısını net biçimde ortaya koyuyor:
- Rakip karar ve sınıflandırma modellerinde genel kalibrasyon hatası %10.3 ile %35.0 arasında değişirken,
- Jev 1.13.0 sürümünde bu hata oranı %1.8'e,
- En güncel Jev 1.14.0 sürümünde ise %1.6 seviyesine kadar düşürülmüş durumda.
Bu denli düşük bir kalibrasyon hatası, yapay zeka ajanlarında Jev ile halüsinasyon önleme süreçlerinde yazılımcıların if (confidence > 0.85) gibi koşullu ifadeleri tam bir matematiksel güvenle yazabilmesini sağlar.
RLCD: Kalibre Edilmiş Kararlar İçin Pekiştirmeli Öğrenme
Jev'in %1.6 gibi olağanüstü bir kalibrasyon doğruluğuna ulaşmasının sırrı, RLCD (Reinforcement Learning for Calibrated Decisions) adı verilen özel eğitim metodolojisinde yatıyor.
Standart modellerde kullanılan RLHF (İnsan Geri Bildirimi) veya RLVR (Doğrulanabilir Ödüller), modeli yalnızca doğru cevabı bulduğunda ödüllendirir. Bu durum, modelin emin olmadığı sorularda bile "kumar oynamasına" ve yüksek özgüvenli tahminler atmasına neden olur. RLCD ise uygun kurallı puanlama fonksiyonlarını (proper scoring rules - örneğin Brier skoru ve logaritmik kayıp türevleri) doğrudan pekiştirmeli öğrenme ödül mekanizmasına entegre eder:
- Model doğru cevabı yüksek güvenle bildiğinde yüksek ödül alır.
- Model yanlış cevaba yüksek güven verdiğinde çok ağır şekilde cezalandırılır.
- Model bilmediği veya belirsiz bir durumda dürüstçe düşük güven skoru (örneğin %50-%50 dağılım) verdiğinde ise cezalandırılmaz, aksine dürüst kalibrasyonu koruduğu için ödüllendirilir.
Sonuç olarak TypeSafe AI'ın System One mimarisi ve Jev karar motoru, yapay zekayı belirsiz bir "sohbet kutusu" olmaktan çıkarıp, geleneksel yazılım mühendisliğinin katı tip güvenliği ve determinizm kurallarıyla tam uyumlu bir sistem bileşenine dönüştürüyor.