AI Model Karşılaştırması konusunda içerik üretirken yalnızca teknik tanımlar paylaşmakla yetinmiyorum; karar alma süreçlerine, ekip içi iletişimde işe yarayan formatlara ve yeni başlayanların sıklıkla kaçırdığı üretkenlik fırsatlarına da odaklanıyorum. Her yazının öncesinde kapsamlı araştırma notları çıkarıyor, farklı senaryolarda test ettiğim yaklaşımları ölçüyor ve sonuçları okunabilir bir çerçeveye yerleştiriyorum. Böylece hem deneyimli profesyoneller hem de bu başlıkla yeni tanışanlar için tekrar ziyaret etmeye değer yaşayan bir kaynak ortaya çıkıyor.
“DeepSeek V4.1-Flash Yenilendi: En İyi Açık Model Nasıl Daha Güçlü ve Verimli Hale Geldi?” başlıklı yazı, öne çıkan yazılardan biri. Açık ağırlıklı yapay zeka modelleri arasında zirvede yer alan DeepSeek V4.1-Flash, aldığı yeni güncellemeyle hem daha az token harcayarak görevleri çok daha hızlı tamamlıyor hem de kapalı kaynaklı amiral gemisi modellerle başa baş rekabet ediyor. Yazıyı hazırlarken yalnızca teoriyi değil, uygulama sırasında karşılaştığım tuzakları ve başarılı teslimatlar için kritik gördüğüm kontrol listelerini de paylaştım. Yazıda ayrıca DeepSeek, Yapay Zeka, AI başlıklarıyla ilgili bağlantılar da bulunuyor; bu bağlantılar ai model karşılaştırması gündemini tamamlayacak ek öğrenme yollarına işaret ediyor. Yazının sonunda yer alan pratik öneriler, konuyu kendi ekiplerine uyarlamak isteyen okuyucuların hızlıca sonuç üretmesine yardımcı oluyor.
“DeepSeek V4.1-Flash-1017 Performans Testleri ve Ajan Ekosistemi: Terminal-Bench 4.0 Sıçraması” başlıklı yazı, seriyi derinleştiren içeriklerden biri. DeepSeek, 552 milyar parametreli MoE mimarisine sahip V4.1-Flash-1017 güncellemesiyle Terminal-Bench 4.0 skorunu 42.3'e, Humanity's Last Exam başarısını 42.6'ya taşırken Claude Code, DeepSeek Harness ve Tencent CodeBuddy gibi ajan çerçeveleriyle kutudan çıktığı gibi tam optimizasyon sunuyor. Yazıyı hazırlarken yalnızca teoriyi değil, uygulama sırasında karşılaştığım tuzakları ve başarılı teslimatlar için kritik gördüğüm kontrol listelerini de paylaştım. Yazıda ayrıca DeepSeek, Yapay Zeka, AI başlıklarıyla ilgili bağlantılar da bulunuyor; bu bağlantılar ai model karşılaştırması gündemini tamamlayacak ek öğrenme yollarına işaret ediyor. Yazının sonunda yer alan pratik öneriler, konuyu kendi ekiplerine uyarlamak isteyen okuyucuların hızlıca sonuç üretmesine yardımcı oluyor.
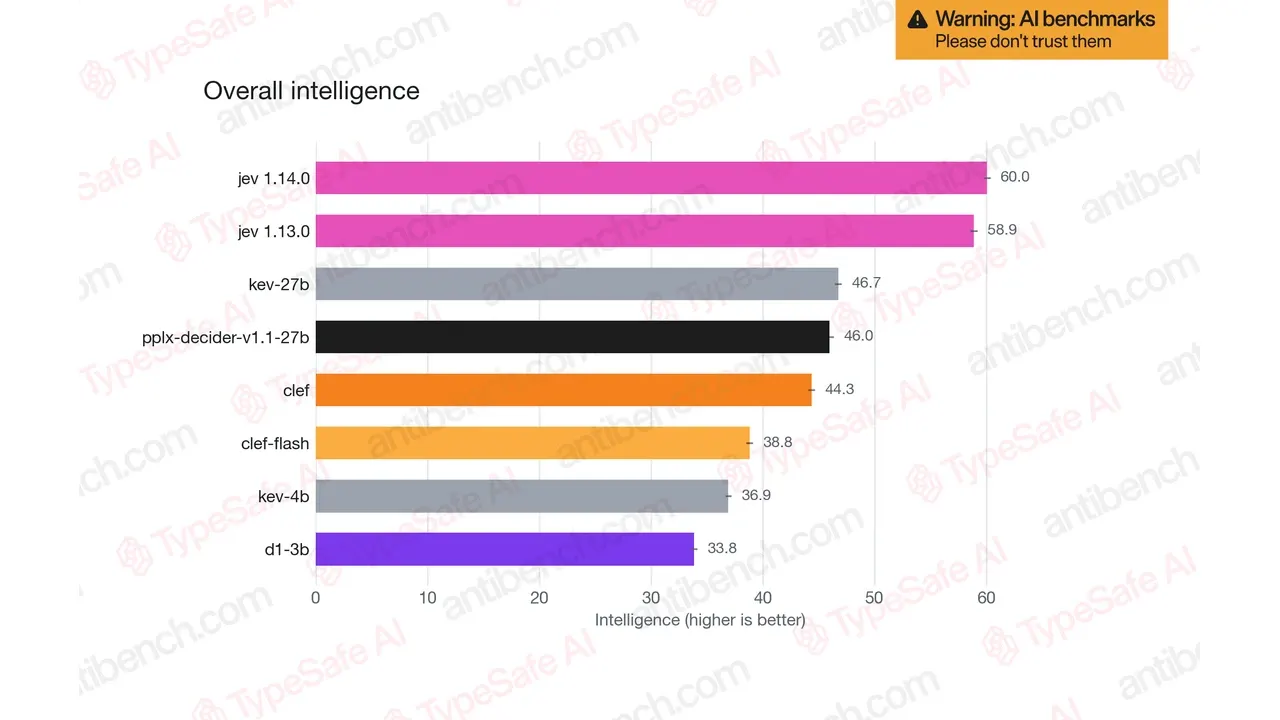
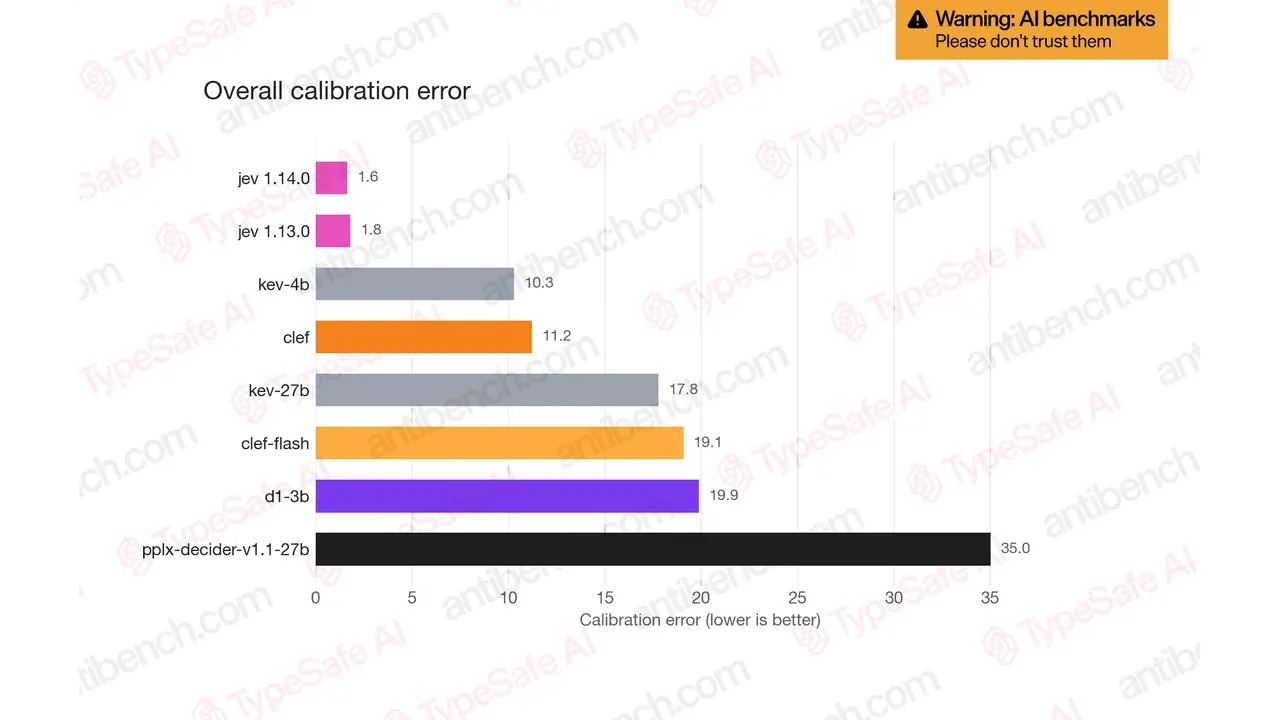
“Jev ve AWS Strands Decider 2B Karşılaştırması: Hangi Karar Modeli Seçilmeli?” başlıklı yazı, uygulamaya dönük örneklerden biri. Yapay zeka ajanlarında yeni standart haline gelen karar modellerinin iki önemli temsilcisi TypeSafe AI Jev ve AWS Strands Decider 2B'yi; zeka skoru, yerel çalışma, kalibrasyon ve maliyet ekseninde kıyaslıyoruz. Yazıyı hazırlarken yalnızca teoriyi değil, uygulama sırasında karşılaştığım tuzakları ve başarılı teslimatlar için kritik gördüğüm kontrol listelerini de paylaştım. Yazıda ayrıca Jev, Yapay Zeka, AI Agents başlıklarıyla ilgili bağlantılar da bulunuyor; bu bağlantılar ai model karşılaştırması gündemini tamamlayacak ek öğrenme yollarına işaret ediyor. Yazının sonunda yer alan pratik öneriler, konuyu kendi ekiplerine uyarlamak isteyen okuyucuların hızlıca sonuç üretmesine yardımcı oluyor.
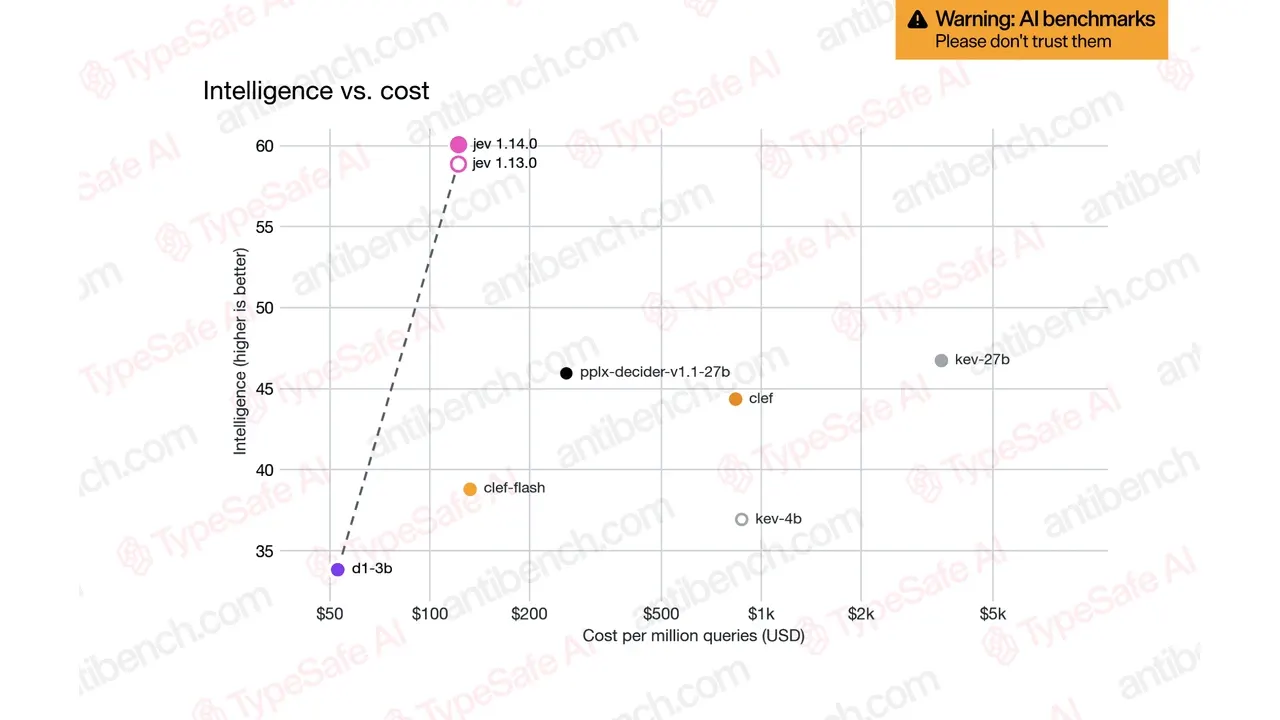
“Jev vs Geleneksel LLM’ler: Karar Modellerinde Gecikme ve Maliyet Karşılaştırması” başlıklı yazı, stratejik planlamayı öne çıkaran bölümlerden biri. Üretim ortamındaki yapay zeka iş akışlarında geleneksel büyük dil modelleri yerine TypeSafe AI'ın Jev karar modelini kullanmanın milisaniyelik gecikme avantajlarını ve sıfır çıktı token maliyetini detaylı inceliyoruz. Yazıyı hazırlarken yalnızca teoriyi değil, uygulama sırasında karşılaştığım tuzakları ve başarılı teslimatlar için kritik gördüğüm kontrol listelerini de paylaştım. Yazıda ayrıca Jev, Yapay Zeka, AI başlıklarıyla ilgili bağlantılar da bulunuyor; bu bağlantılar ai model karşılaştırması gündemini tamamlayacak ek öğrenme yollarına işaret ediyor. Yazının sonunda yer alan pratik öneriler, konuyu kendi ekiplerine uyarlamak isteyen okuyucuların hızlıca sonuç üretmesine yardımcı oluyor.
“TypeSafe AI System One Mimarisi Nedir? Jev Karar Motorunun Teknik Çalışma Prensibi” başlıklı yazı, toparlayıcı notları paylaşan kaynaklardan biri. Daniel Kahneman'ın bilişsel teorisinden ilham alan TypeSafe AI System One mimarisinin teknik detaylarını, RLCD eğitim metodolojisini ve Jev modelinin %1.6'lık rekor kalibrasyon doğruluğunu inceliyoruz. Yazıyı hazırlarken yalnızca teoriyi değil, uygulama sırasında karşılaştığım tuzakları ve başarılı teslimatlar için kritik gördüğüm kontrol listelerini de paylaştım. Yazıda ayrıca Jev, Yapay Zeka, AI başlıklarıyla ilgili bağlantılar da bulunuyor; bu bağlantılar ai model karşılaştırması gündemini tamamlayacak ek öğrenme yollarına işaret ediyor. Yazının sonunda yer alan pratik öneriler, konuyu kendi ekiplerine uyarlamak isteyen okuyucuların hızlıca sonuç üretmesine yardımcı oluyor.
AI Model Karşılaştırması etiketi altındaki her yeni içerik, denediğim iş akışlarının ve geliştirici topluluğundan gelen soruların bir sonucu olarak şekilleniyor. Yazıları güncel tutmak için hem araçlardaki değişiklikleri takip ediyor hem de sahada karşılaşılan taze örnekleri eklemeye devam ediyorum. Bu yaklaşım sayesinde, sayfayı düzenli aralıklarla ziyaret eden okuyucular yalnızca haber almakla kalmıyor; aynı zamanda kendi planlarını gözden geçirmek için referans bir çerçeve de ediniyor.
AI Model Karşılaştırması başlığındaki yolculuğu yakından izlemek isterseniz, blogu kaynağınıza ekleyebilir, bültene abone olabilir ve sosyal kanallar üzerinden gönderdiğiniz tüm geri bildirimleri bu sayfaya taşıyabilirsiniz. Yeni yazılar eklendikçe rehberi güncelleyerek, her paragrafta gerçek projelerden süzülen deneyimi paylaşmaya devam edeceğim. Böylece ai model karşılaştırması alanındaki planlarınızı şekillendirirken ihtiyaç duyduğunuz veri, örnek ve anlatım tek bir yerde erişilebilir olacak.