Yapay Zeka Ajanlarında (AI Agents) Jev ile Halüsinasyon Önleme ve Güven Skoru Yönetimi
Otonom yapay zeka ajanlarının üretim ortamında yanlış fonksiyon çağırma ve şema bozma sorunlarını, TypeSafe AI Jev modelinin sıfır tip hatası ve kalibre edilmiş güven skoru mimarisiyle nasıl çözebileceğinizi inceliyoruz.
Otonom yapay zeka ajanları (AI Agents), yalnızca metin üreten sohbet botlarından çıkıp veritabanlarını güncelleyen, terminal komutları çalıştıran, ödeme iadeleri yapan ve siber güvenlik duvarlarını yöneten aktif yazılım bileşenlerine dönüştü. Ancak bir ajana gerçek dünyada aksiyon alma yetkisi (tool calling) verdiğinizde, geleneksel büyük dil modellerinin en zayıf karnı olan halüsinasyon ve yapılandırılmış çıktı hataları doğrudan operasyonel bir güvenlik riskine dönüşür.
Bir sohbet botunun şiir yazarken kelime uydurması zararsızdır; fakat müşteri veritabanına bağlı bir ajanın fonksiyon parametrelerini halüsinasyonla doldurması veya yanlış aracı tetiklemesi geri döndürülemez veri kayıplarına yol açabilir. İşte bu noktada TypeSafe AI'ın geliştirdiği Jev karar modeli, ajan mimarilerinde güvenliği sağlayan deterministik bir emniyet sübabı olarak öne çıkıyor.
Ajanların En Büyük Problemi: Birleşik Hata Oranı (Compounding Error)
Çok adımlı bir ajan iş akışında (örneğin 10 ardışık karar gerektiren bir otomasyonda), kullandığınız dil modelinin her adımda %95 doğrulukla araç seçtiğini varsayalım. İlk bakışta %95 yüksek bir başarı gibi görünse de, 10 adımın sonunda tüm iş akışının hatasız tamamlanma olasılığı matematiksel olarak $(0.95)^{10} \approx \%59.8$ seviyesine düşer.
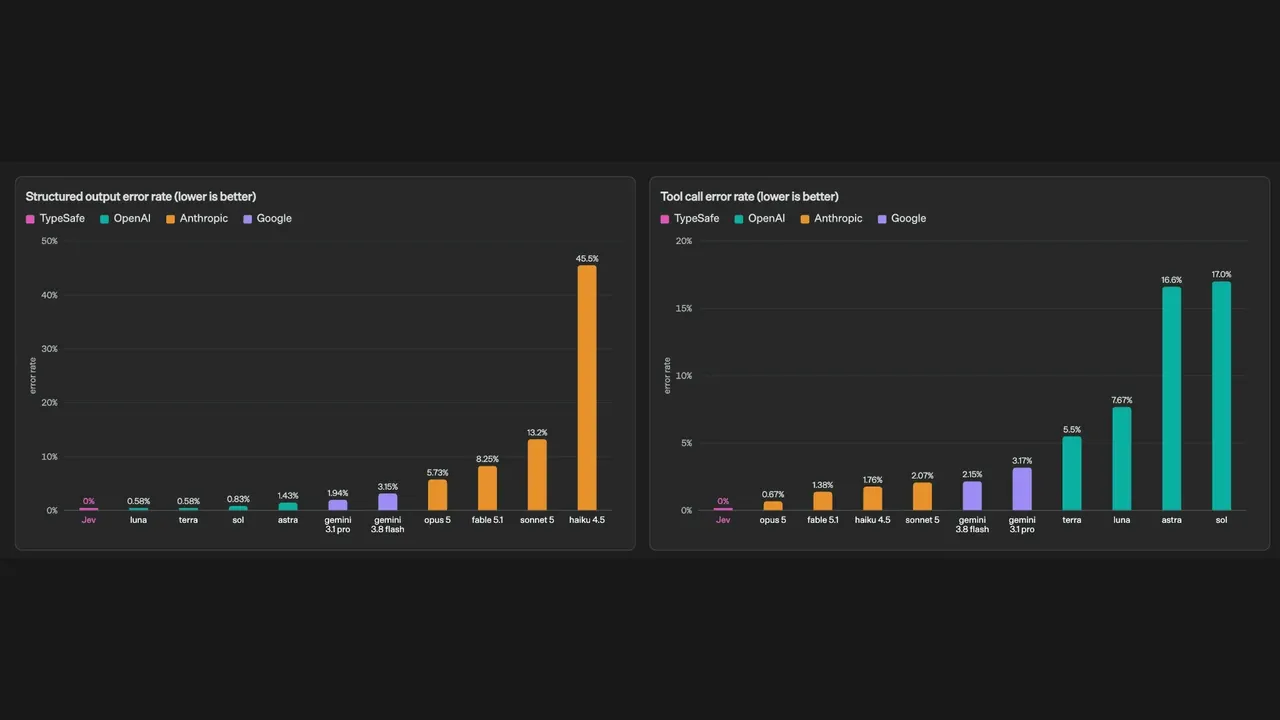
Üstelik TypeSafe AI tarafından paylaşılan güncel kıyaslama verileri, en gelişmiş sınır (frontier) modellerin bile yapılandırılmış çıktı (structured output) ve araç çağırma (tool call) süreçlerinde ciddi hata oranlarına sahip olduğunu gösteriyor:
- Geleneksel hafif ve hızlı modellerde yapılandırılmış çıktı hata oranları %13 ila %45 seviyelerine kadar çıkabiliyor.
- Amiral gemisi modellerde dahi araç çağırma hata oranları %0.67 ile %17 arasında seyrediyor.
- Jev modelinde ise mimari tasarım gereği hem yapılandırılmış çıktı hatası hem de geçersiz araç çağırma oranı %0 olarak ölçülüyor.
Jev Halüsinasyonu Mimari Olarak Nasıl İmkansız Kılıyor?
Geleneksel LLM'ler, bir fonksiyonu çağırırken bile aslında metin (JSON formatında bir karakter dizisi) üretirler. Model, sözlüğündeki yüz binlerce token arasından seçim yaparken tırnak işaretini unutabilir, şemada olmayan bir parametre uydurabilir veya sayısal bir alana metin yazabilir.
Jev nedir yazımızda temelini anlattığımız üzere Jev, serbest metin üretme yeteneği tamamen budanmış bir System One modelidir:
1. Sınırlandırılmış Karar Uzayı: Jev'e 4 olası eylem (Choice) tanımladığınızda, modelin çıktı katmanı yalnızca bu 4 seçeneğin olasılık dağılımını hesaplar. Beşinci bir seçeneği uydurması (halüsinasyon görmesi) matematiksel olarak mümkün değildir.
2. Sıfır Şema Kırılması: Çıktılar serbest metin ayrıştırmasıyla (JSON parse) değil, doğrudan tip güvenli ilkellerle (Bool, Score, Choice) üretildiği için sözdizimi (syntax) hatası oluşmaz.
Jev Nasıl Kullanılır? TypeSafe AI Karar Modelinde İlk Örnek
Jev Nedir? TypeSafe AI'ın Hızlı Karar Verme Modeli ve Potansiyeli
Epistemik Dürüstlük: Kalibre Edilmiş Güven Skoru Yönetimi
Yapay zeka ajanlarında halüsinasyonun ikinci boyutu, modelin bilmediği bir şeyi biliyormuş gibi yüksek özgüvenle yapmasıdır. Standart RLHF (İnsan Geri Bildirimli Pekiştirmeli Öğrenme) ile eğitilen dil modelleri, kullanıcıyı memnun etmek üzere şartlandırıldıkları için emin olmadıkları durumlarda bile rastgele bir aracı seçmeye eğilimlidir.
Jev ise RLCD (Reinforcement Learning for Calibrated Decisions) yöntemiyle eğitilmiştir. Bu eğitim disiplini modele "epistemik dürüstlük" kazandırır:
- Model, verilen bağlamda doğru kararı bulmak için yeterli kanıt yoksa yüksek bir güven skoru üretmez; kararsızlığını dürüstçe düşük bir
confidencedeğeriyle raporlar. - Böylece Next.js ve TypeScript ile Jev entegrasyonu rehberimizde gösterdiğimiz gibi, yazılım mühendisleri ajan döngüsünün içine kesin güvenlik bariyerleri (guardrails) koyabilir.
Güvenli Ajan Mimarisi İçin "Gri Bölge" (Grey-Zone) Stratejisi
Jev kullanarak üretim ortamında sıfır halüsinasyonlu bir ajan kurgularken ikili (evet/hayır) düşünmek yerine üç bölgeli karar matrisi uygulamak en iyi mühendislik pratiğidir:
1. Yeşil Bölge (Güven Skoru > 0.85): Kanıtlar net ve model kararından emin. Ajan, seçilen aracı (örneğin hesabı askıya alma veya siparişi onaylama) otonom olarak anında çalıştırır.
2. Kırmızı Bölge (Güven Skoru < 0.25): İstek açıkça reddedilmeli veya işlem iptal edilmelidir. Ajan hiçbir yan etki (side-effect) yaratmadan süreci kapatır.
3. Gri Bölge (0.25 - 0.85 Arası): İşte halüsinasyonların engellendiği yer burasıdır. Girdi verisi çelişkilidir veya sıra dışı bir durum (edge-case) vardır. Jev bu belirsizliği yakalar ve ajanı otomatik işlem yapmaktan alıkoyarak isteği ya bir insan operatörün onay kuyruğuna (human-in-the-loop) ya da derin analiz yapacak bir üst modele yönlendirir.
Siber güvenlik operasyonlarından (SOC otomasyonu) finansal işlemlere kadar hata toleransının sıfır olduğu alanlarda Jev, otonom ajanların kontrolsüzce yanlış fonksiyonları tetiklemesini önleyen en güvenilir kontrol katmanını oluşturuyor.