Tavus Griffin: Gerçek Zamanlı Yüz Yüze Konuşabilen İlk Yapay Zeka Modeli
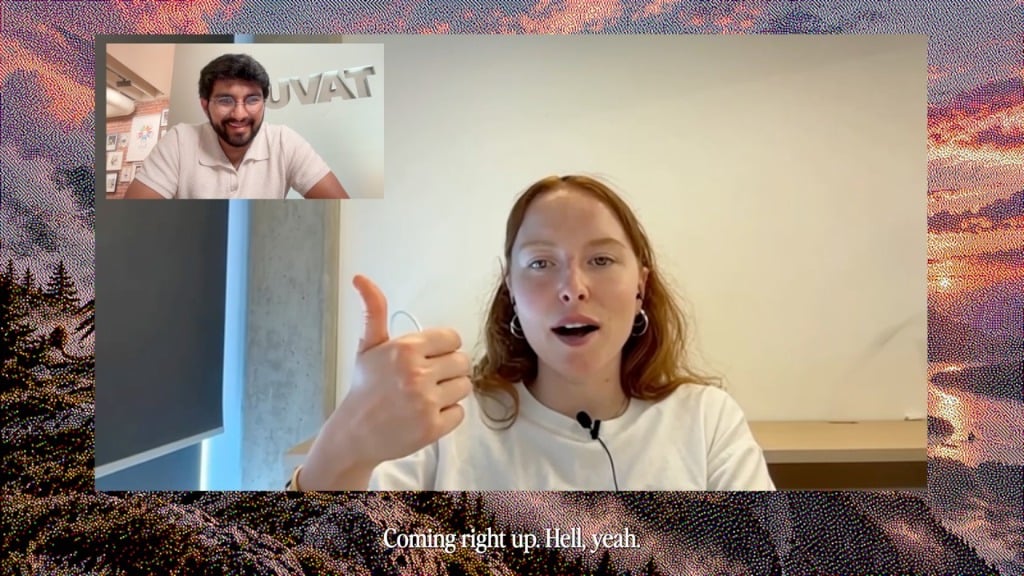
Tavus tarafından duyurulan Griffin, gerçek zamanlı video görüşmelerinde jest ve mimikleri anlayıp insan benzeri anlık tepkiler veren çığır açıcı bir İnsan Etkileşim Modeli (HIM).
Yapay zeka ekosisteminde bugüne dek geliştirilen ses ve metin tabanlı sohbet sistemleri, kullanıcıların belirli bir komut vermesi veya konuşmasını tamamen bitirip beklemesi mantığına dayanıyordu. Konuşma sırasını sıralı adımlarla belirleyen bu klasik yaklaşım, doğal insan iletişiminin en temel parçaları olan mimikleri, göz temasını, duraksamaları ve anlık tepkileri büyük oranda göz ardı ediyordu. Üretken video ve ses teknolojileri geliştiren Tavus şirketi, bu dinamikleri kökten dönüştürmeyi hedefleyen yeni yapay zeka modeli Griffin'i duyurdu.
Geleneksel büyük dil modellerinden (LLM) farklı bir kategori olarak konumlandırılan Griffin, sektörde İnsan Etkileşim Modeli (Human Interaction Model - HIM) olarak adlandırılan yeni bir sınıfın öncüsü sayılıyor. Model, görüntülü görüşme esnasında yalnızca söylenen kelimeleri değil; karşısındaki kişinin yüz ifadelerini, bakış doğrultusunu, beden hareketlerini ve duraksama anlarını eş zamanlı analiz ederek insan doğallığında ses, mimik ve jest tepkileri üretebiliyor.
Geleneksel Sıralı Modellerin Ötesinde: Full-Duplex Mimarisi
Klasik yapay zeka sesli asistanları genellikle üç aşamalı bir döngüde çalışır: Konuşma metne dönüştürülür (STT), dil modeli yanıtı üretir (LLM) ve ardından üretilen metin seslendirilir (TTS). Bu sıralı süreç, konuşmanın doğal ritmini bozan gecikmelere ve robotik bir iletişime yol açar. Kullanıcı düşünmek için birkaç saniye durakladığında sistem cümlenin bittiğini varsayarak sözü kesebilir veya gereksiz yere devreye girebilir.
Tavus Griffin, bu sorunu saniyenin altında gerçekleşen Full-Duplex mini dönüşler mimarisiyle çözüyor. Model, konuşmanın durumunu milisaniyeler bazında sürekli yeniden hesaplıyor. Bu sayede kullanıcı henüz konuşmasını tamamlamamışken sistem dinlediğini belirten küçük bir baş sallama hareketi yapabiliyor, "hı-hı" veya "anlıyorum" gibi onay sesleri çıkarabiliyor ya da tam yerinde araya girip konuşma sırasını devralabiliyor.
Aşağıdaki resmi duyuru paylaşımında Tavus ekibinin Griffin ile gerçekleştirdiği etkileyici canlı etkileşim demolarını inceleyebilirsiniz:
Gerçek Zamanlı Video Turing Testinde Çarpıcı Başarı
Metin veya salt ses tabanlı yapay zekaların insanları yanıltma başarısı günümüzde oldukça yüksek seviyelere ulaştı. Ancak iş canlı video akışına ve anlık görsel tepkilere geldiğinde insan gözü en ufak yapaylığı dahi kolayca fark edebiliyor. Tavus'un gerçekleştirdiği kapsamlı kullanıcı testinde Griffin bu algıyı kırmayı başardı.
Gerçekleştirilen kör testlerde 54 katılımcıya, başka bir insanla bir dakikalık standart görüntülü görüşme yapacakları söylendi. Ancak ekranın diğer tarafında Griffin-Lite altyapısıyla çalışan, sesi ve görüntüsü anlık üretilen bir PAL (dijital insan temsili) bulunuyordu. Görüşme sonunda katılımcıların yüzde 48'i karşılarındaki kişinin gerçek bir insan olduğuna kesin olarak inandı. Katılımcıların yarısından fazlası ise görüşme boyunca karşı tarafın bir yapay zeka olabileceğine dair hiçbir şüphe duymadı.
- 7 puan üzerinden yapılan ayrıntılı memnuniyet ve doğallık değerlendirmelerinde Griffin-Lite şu skorlara imza attı:
- Doğal Görünüm: 5,4 / 7
- Güvenilirlik Hissi: 5,6 / 7
- Yeniden Konuşma İsteği: 5,8 / 7
- Gerçekten Dinleme Algısı: 5,5 / 7
Griffin'in Çift Motorlu Teknik Altyapısı
Tavus mühendisleri, Griffin modelini birbirinden bağımsız çalışmayan iki ana bileşen üzerine inşa etti:
RSI Agent: Model Eğitmeden Deneyim Kazanan Otonom Ajan Mimarisi

Perplexity Windows İçin Portable Computer'ı Duyurdu: Yerel Yapay Zeka ve Crusoe AI Ortaklığı
1. Sürekli Konuşma Modelleme (Continuous Conversational Modeling)
Bu motor gelen ses ve video sinyallerini eş zamanlı olarak dinler ve inceler. Karşıdaki kişinin yüzündeki mikro ifadeleri, bakış yönünü, kameraya tuttuğu bir nesneyi veya konuşma temposunu saniyede onlarca kez kontrol ederek hangi kontrol sinyallerinin üretileceğine karar verir.2. Görsel-İşitsel Üretim Motoru (Audio-Visual Generation)
Konuşma modelinden gelen kontrol sinyallerini kullanarak milisaniyeler içinde ses ve piksel düzeyinde video akışı oluşturur. Griffin, yalnızca kafa bölgesini hareket ettiren basit bir avatar değil; tek bir referans kareden yola çıkarak gövdeyi, omuz hareketlerini, elleri, parmakları, gölgeleri ve arka plan aydınlatmasını gerçek zamanlı olarak bütünüyle sentezler.Nvidia VideoFDB Benchmark Sonuçları
Griffin-Lite'ın yetenekleri bağımsız testlerle de tescillendi. Nvidia'nın çift yönlü görsel ve işitsel etkileşim performansını ölçen VideoFDB kıyaslama testinde model, rakiplerine karşı belirgin bir üstünlük sağladı:
- Görsel ve Ses Üretim Kalitesi (5 üzerinden): Griffin-Lite 3,83 puan alırken, insan referansı 3,92 olarak belirlendi. Aynı kategoride Gemini 2.5 + Anam bileşimi 2,80 puanda kaldı.
- Etkileşim ve Karşı Tarafı Anlama Yeteneği (5 üzerinden): Griffin-Lite 3,73 puan elde etti. Bu kategoride insan referansı 4,20 olurken; MiniCPM-o 4.5 modeli 3,44, Gemini 2.5 Flash Native 3,17 ve OpenAI gpt-realtime ise 2,97 puana ulaşabildi.
Potansiyel Kullanım Alanları ve Güvenlik Önlemleri
İnsan Etkileşim Modelleri müşteri ilişkilerinden eğitime kadar geniş bir yelpazede yeni imkanlar sunuyor. Örneğin dijital bir öğretmen, öğrencinin soru çözerken takıldığını yüz ifadesindeki kararsızlıktan anlayıp anlatım yöntemini değiştirebilir. Müşteri destek süreçlerinde ise kullanıcı bozulan cihazını kameraya gösterdiğinde teknik terimler bilmesine gerek kalmadan doğrudan parça üzerinden tarif alabilir.
Bu denli gerçekçi video ve ses sentezi kabiliyeti, beraberinde deepfake ve sosyal mühendislik dolandırıcılığı gibi ciddi güvenlik risklerini de getiriyor. Bu nedenle Tavus, Griffin-Lite modelini henüz doğrudan halka açmadı. Şirket, yapay zeka olduğunu açıkça belirten şeffaflık ve güvenlik mekanizmalarını tamamlayana kadar modeli yalnızca yetkili araştırma ortaklarıyla test etmeye devam ediyor.